
Стенд демонстрирует подход к построению сетей в ЦОД — Routing to the Host. В этой модели сетевой уровень (L3) заканчивается не на коммутаторе, а непосредственно на сервере (хосте). Это позволяет избавиться от ограничений L2-сетей (таких как STP, ARP-штормы и неэффективное использование каналов) и обеспечить максимальную масштабируемость.
Стенд успешно демонстрирует отказоустойчивость (через BFD и Anycast) и горизонтальное масштабирование(через ECMP). В качестве примера развертывания в рассматриваемой топологии применяется кластер ОТВ эв3
Содержание
- 1 Введение и концепция
- 2 Логическая схема стенда L3 Clos Fabric (Host-based Routing)
- 2.1 Ключевые параметры стенда
- 3 Разбор компонентов и механизмов работы
- 3.1 Агрегация и ECMP (Equal-Cost Multi-Path)
- 3.2 Пример конфигурации одного из программных BGP роутеров (frr1)
- 3.3. Пример конфигурации классической реализации L3 to the Host на примере os-hci-0001 (одного из узлов кластера ОТВ эв3)
- 3.4. Пример конфигурации сетевого интерфейса для работы базы данных и виртуального адреса
- 3.5. Anycast как замена VRRP
- 3.6. Быстрое обнаружение отказов (BFD)
- 4 Анализ топологии стенда
- 5 Перенос на физическую архитектуру Leaf-Spine
- 5.1 Spine (Магистральные коммутаторы)
- 5.2 Leaf (Коммутаторы доступа)
- 5.3 Роль Leaf-коммутатора (ToR)
- 5.4 Преимущества сохранения L3 в ОС (Host-based Routing)
-
- 5.5 Техническая реализация на «железе»
- 5.5.1 BGP Unnumbered (RFC 5549)
- 5.5.2 Dual-ToR и ECMP
- 6 Итоговый вывод для стратегии развития 14
1 Введение и концепция
Стенд демонстрирует подход к построению сетей в ЦОД — Routing to the Host. В этой модели сетевой уровень (L3) заканчивается не на коммутаторе, а непосредственно на сервере (хосте). Это позволяет избавиться от ограничений L2-сетей (таких как STP, ARP-штормы и неэффективное использование каналов) и обеспечить максимальную масштабируемость.
Стенд успешно демонстрирует отказоустойчивость (через BFD и Anycast) и горизонтальное масштабирование(через ECMP). В качестве примера развертывания в рассматриваемой топологии применяется кластер ОТВ эв3
Статус стенда:
- Логическая структура: L3 Clos Fabric (Spine-Leaf топология, где хост является Leaf-узлом).
- Data Plane: ECMP балансировка на 3 узла работает корректно (подтверждено финальным скриптом).
- Control Plane: BGP Anycast обеспечивает отказоустойчивость без использования VRRP/Keepalived.
- Cходимость (Convergence): BFD настроен и готов к мгновенному обнаружению сбоев.
Данная конфигурация рекомендована для высоконагруженных кластеров баз данных, Kubernetes-инфраструктур, построения облаков и является приоритетной для развертывания ОТВ эв3. При переходе на физическое оборудование рекомендуется рассмотреть использование BGP Unnumbered (RFC 5549), чтобы не тратить IP-адреса на Point-to-Point линки между устройствами.
2 Логическая схема стенда L3 Clos Fabric (Host-based Routing)
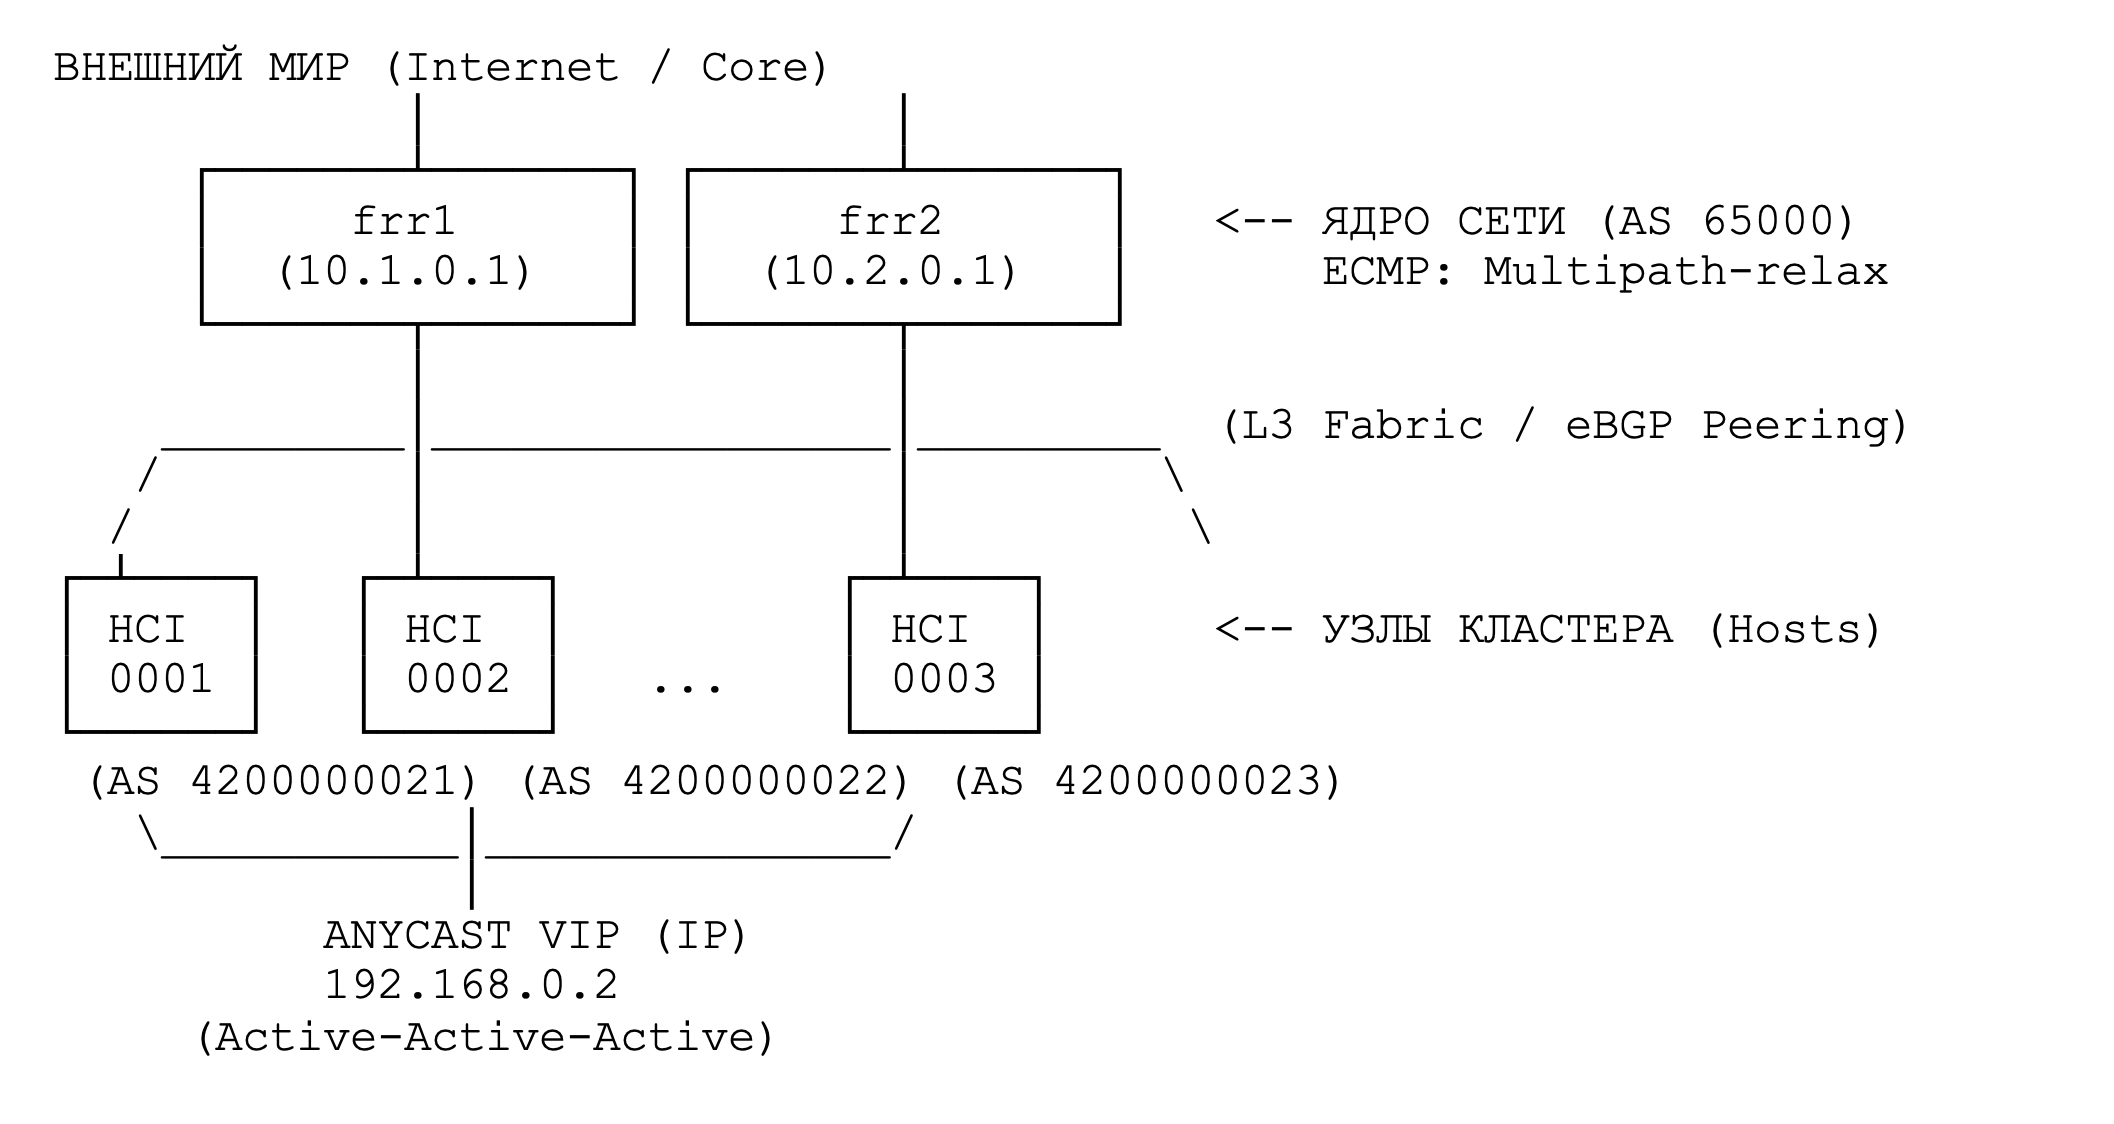
2.1 Ключевые параметры стенда
Spine Layer (frr1, frr2): * AS: 65000.
- Функция: Агрегация анонсов от хостов и балансировка (ECMP).
- Особенности: Принимает /32 маршруты от хостов, отдает 0.0.0.0/0 (Default route).
Host Layer (hci-000x):
- AS: 4200000021, 4200000022, 4200000023 (использованы 32 битные номера AS)
- Функция: Анонс собственного Loopback IP и общего Anycast VIP.
- Особенности: Использование BFD для мгновенного переключения при аварии.
Anycast VIP (192.168.0.2):
- Единая точка входа для Restful API ОТВ эв3.
- Доступность обеспечивается всеми узлами одновременно.
Эта схема является vendor-neutral и будет одинаково работать на базе Open Source (FRR, SONiC) и на проприетарном железе (Cisco, Juniper, Arista, Hyawei), так как опирается исключительно на стандартные RFC протоколов BGP и BFD.
3 Разбор компонентов и механизмов работы
3.1 Агрегация и ECMP (Equal-Cost Multi-Path)
На маршрутизаторах frr1 и frr2 настроена функция maximum-paths 64 и as-path multipath-relax.
- Как это работает: Маршрутизатор видит три одинаковых пути к VIP-адресу 192.168.0.2/32 (через каждый узел HCI ОТВ эв3).
- Результат: Трафик распределяется по всем доступным путям одновременно. Это кратно увеличивает пропускную способность и обеспечивает балансировку нагрузки без использования выделенных Load Balancer'ов.
3.2 Пример конфигурации одного из программных BGP роутеров (frr1)
Основная особенность — использование динамических соседей, что критически важно для масштабируемых Clos-сетей, где новые Leaf-узлы должны подключаться автоматически без ручной правки типовой конфигурации на Spine.
frr defaults traditional
hostname frr1
log file /var/log/frr/frr.log
no ipv6 forwarding
service integrated-vtysh-config
route-map ALLOW-ALL permit 10
!
router bgp 65000
 bgp router-id 10.1.0.1
 ! Разрение на балансировку между разными AS, на тот случай,
 ! если используем разные автономные системы
 bgp bestpath as-path multipath-relax
 neighbor HCI-DYNAMIC peer-group
 neighbor HCI-DYNAMIC remote-as external
 neighbor HCI-DYNAMIC bfd
 bgp listen limit 10
 bgp listen range 10.1.0.0/24 peer-group HCI-DYNAMIC
 !
 address-family ipv4 unicast
  maximum-paths 64
  maximum-paths ibgp 64
  network 10.1.0.0/24
  neighbor HCI-DYNAMIC next-hop-unchanged
  neighbor HCI-DYNAMIC default-originate
  neighbor HCI-DYNAMIC route-map ALLOW-ALL in
  neighbor HCI-DYNAMIC route-map ALLOW-ALL out
 exit-address-family
exit
Общие системные параметры
frr defaults traditional: устанавливает классические значения таймеров и параметров протоколов, привычные для опытных сетевых инженеров.service integrated-vtysh-config: сохраняет всю конфигурацию в один файл (frr.conf), а не разбивает её по демонам (bgpd, ospfd и т.д.).route-map ALLOW-ALL permit 10: простейший фильтр, который разрешает всё. Здесь он используется для того, чтобы явно разрешить прием и анонс маршрутов
Глобальные настройки BGP
router bgp 65000: запуск процесса BGP в автономной системе 65000.
bgp bestpath as-path multipath-relax: ключевая команда для Clos-сетей. Она позволяет балансировать трафик (ECMP) между путями, которые имеют одинаковую длину AS-Path, но разные номера самих AS. Без неё BGP считал бы такие пути разными.
bgp listen range 10.1.0.0/24 peer-group HCI-DYNAMIC: включает режим Dynamic Neighbors. Маршрутизатор будет «слушать» входящие BGP-соединения из подсети 10.1.0.0/24 и автоматически создавать сессии, применяя к ним настройки группы HCI-DYNAMIC.
bgp listen limit 10: ограничивает максимальное количество таких динамических соседей числом 10.
Описание группы соседей (Peer Group)
neighbor HCI-DYNAMIC remote-as external: указывает, что все динамические соседи будут внешними (eBGP). Конкретный номер AS соседа будет определен в момент установления соединения.neighbor HCI-DYNAMIC bfd: включает механизм BFD для мгновенного (миллисекунды) обнаружения падения линка с соседом.
Настройки Address Family (IPv4 Unicast)
В этой секции определяются правила передачи маршрутов:
maximum-paths 64: разрешает использовать до 64 путей для балансировки трафика (ECMP) к одной цели.network 10.1.0.0/24: анонсирует собственную сеть соседям.neighbor HCI-DYNAMIC next-hop-unchanged: заставляет роутер не менять атрибут next-hop при передаче маршрутов дальше. Обычно используется в сложных eBGP-дизайнах, чтобы сохранить оригинальный адрес источника.neighbor HCI-DYNAMIC default-originate: автоматически анонсирует маршрут по умолчанию (0.0.0.0/0) всем динамическим соседям.
3.3 Пример конфигурации классической реализации L3 to the Host на примере hci-0001 (одного из узлов кластера ОТВ эв3)
В представленной ниже конфигурации сервер сам является участником BGP-процесса. Это позволяет избавиться от L2-технологий (MLAG/LACP) и использовать ECMP для балансировки трафика и мгновенной сходимости.
frr defaults traditional
hostname hci-0001
log file /var/log/frr/frr.log
!
ip forwarding
!
ip prefix-list HCI-NET permit 192.168.0.0/22 ge 32
!
route-map RM-HCI-NET permit 10
 match ip address prefix-list HCI-NET
 set origin igp
!
router bgp 4200000021
 bgp router-id 192.168.0.21
 !
 neighbor 10.1.0.1 remote-as 65000
 neighbor 10.2.0.1 remote-as 65000
 neighbor 10.1.0.1 allowas-in 1
 neighbor 10.2.0.1 allowas-in 1
 neighbor 10.1.0.1 description ROUTER-FRR-0001
 neighbor 10.2.0.1 description ROUTER-FRR-0002
 neighbor 10.1.0.1 bfd
 neighbor 10.2.0.1 bfd
 !
 address-family ipv4 unicast
  maximum-paths 2
  redistribute connected route-map RM-HCI-NET
  !
  neighbor 10.1.0.1 activate
  neighbor 10.1.0.1 route-map ALLOW-ALL in
  neighbor 10.1.0.1 route-map ALLOW-ALL out
  neighbor 10.2.0.1 activate
  neighbor 10.2.0.1 route-map ALLOW-ALL in
  neighbor 10.2.0.1 route-map ALLOW-ALL out
 exit-address-family
route-map ALLOW-ALL permit 10
exit
Подготовка системы (Layer 3 Readiness)
ip forwarding: Включает на уровне ядра Linux пересылку пакетов. Это превращает сервер из обычного конечного устройства в маршрутизатор.ip prefix-list HCI-NET permit 192.168.0.0/22 ge 32: Создает фильтр, который ищет специфичные маршруты — конкретные IP-адреса хостов (маска /32) внутри сети 192.168.0.0/22. Это нужно для анонса только Loopback-адресов или IP сервисов, запущенных на сервере.
Политика анонсирования (Route-Map)
route-map RM-HCI-NET permit 10:match ip address prefix-list HCI-NET: Берет адреса, прошедшие через фильтр выше.set origin igp: Маркирует их как доверенные (внутренние) для BGP.route-map ALLOW-ALL permit 10: Универсальный пропуск для всех остальных маршрутов (например, для приема 0.0.0.0/0 от Spine).
BGP и отказоустойчивость (Multi-Homing)
router bgp 4200000021: Используется 32-битный номер приватной автономной системы (AS).neighbor 10.1.0.1 и 10.2.0.1: Хост подключается сразу к двум вышестоящим коммутаторам (Spine или Leaf). Это создает избыточность.allowas-in 1: Важный параметр. Позволяет принимать маршруты, в которых уже есть номер AS данного хоста (один раз). Это часто необходимо в сложных топологиях, чтобы избежать циклов, при этом не блокируя легитимные пути.bfd: Включает Bidirectional Forwarding Detection. Если кабель выдернут или порт упадет, BGP узнает об этом за доли секунды (вместо стандартных 90 секунд ожидания), и трафик мгновенно переключится на живого соседа.
Оптимизация трафика (IPv4 Unicast)
maximum-paths 2: Включает ECMP (Equal-Cost Multi-Pathing). Трафик от сервера к сети будет распределяться поровну между обоими линками (10.1.0.1 и 10.2.0.1), удваивая пропускную способность.redistribute connected route-map RM-HCI-NET: Самая важная часть. Сервер берет свои локальные IP-адреса (в данном случае адрес узла базы данных), фильтрует их через RM-HCI-NET и сообщает всей сети, что IP адрес находится прямо здесь.
3.4 Пример конфигурации сетевого интерфейса для работы базы данных и виртуального адреса
Файл конфигурации интерфейсов (/etc/network/interfaces) представленный ниже реализует концепцию IP Unnumbered или Loopback-адресации через использование dummy-интерфейсов, что в архитектуре L3 to the Host является де-факто стандартом.
auto lo
iface lo inet loopback

# пример анонса vip для ОТВ эв3 endpoint
auto vip_adm
iface vip_adm inet static
    address 192.168.0.2
    netmask 255.255.255.255
    pre-up ip link add vip_adm type dummy
    post-down ip link del vip_adm

# пример объявления прикладного адреса для работы приложения.
auto hci
iface hci inet static
    address 192.168.0.21
    netmask 255.255.255.255
    pre-up ip link add hci type dummy
    post-down ip link del hci
В отличие от физических портов (eth0, bond0), dummy-интерфейсы являются виртуальными и всегда находятся в состоянии UP, пока загружена ОС.
- Зачем это нужно: Если сервис (например, MySQL/Galera или API ОТВ эв3) привязан к физическому адресу, и линк на сетевой карте упадет, IP станет недоступен. Интерфейс dummy гарантирует, что адрес доступен локально всегда, а протокол BGP (который мы разбирали ранее) распространит информацию об этом адресе во внешнюю сеть через "живые" аплинки.
netmask 255.255.255.255 (/32): Это ключевой момент. Адрес назначается как «хостовый». Он не принадлежит никакой физической подсети кабеля.pre-up ip link add ... type dummy: Перед поднятием интерфейса система создает виртуальное устройство в ядре.- Назначение
vip_adm: Это Virtual IP (VIP). В связке с конфигом FRR, сервер начнет анонсировать этот IP по BGP. Если на других контроллерах настроено так же, получаем Anycast — трафик к API ОТВ эв3 пойдет на ближайший или живой контроллер.
Преимущества
- Мобильность адресов: Можно перенести IP-адрес на любой другой сервер в дата-центре, просто подняв там такой же dummy-интерфейс. Сеть перестроится автоматически за счет BGP.
- Чистота конфигурации: Приложения (сервисы ОТВ эв3) привязываются к локальному виртуальному адресу, который не зависит от того, подключен сервер в eth0 или eth1.
- Изоляция: Даже если все физические интерфейсы «флапают» (часто поднимаются/падают), внутренние сервисы продолжают считать, что их локальный IP доступен
3.5 Anycast как замена VRRP
Традиционный VRRP/Keepalived работает по принципу Active-Passive (один узел активен, остальные простаивают).
- На стенде: Все три узла гиперконвергентной инфраструктуры ОТВ эв3 одновременно анонсируют один и тот же адрес 192.168.0.2 на интерфейсе lo:vip_admin.
- Преимущество: Реализована схема Active-Active-Active. При падении одного узла BGP-сессия разрывается, и маршрут автоматически удаляется из таблиц соседей
3.6 Быстрое обнаружение отказов (BFD)
Использование протокола BFD на всех узлах позволяет обнаруживать падение линка или зависание демона маршрутизации за доли секунды (миллисекунды). Это, например, критично для баз данных Galera, входящих в состав HCI ОТВ эв3, так как позволяет избежать долгого ожидания тайм-аутов BGP (180 секунд по умолчанию).
4 Анализ топологии стенда
| Узел | AS | Роль | Анонсируемые сети |
|---|---|---|---|
| frr1 / frr2 | 65000 | Сетевое ядро (Spine-analog) | Default route, 10.1.0.0/24 |
| hci-0001 | 4200000021 | Узел HCI (Leaf/Host) | VIP (.2), Host IP (.21) |
| hci-0002 | 4200000022 | Узел HCI (Leaf/Host) | VIP (.2), Host IP (.22) |
| hci-0003 | 4200000023 | Узел HCI (Leaf/Host) | VIP (.2), Host IP (.23) |
Примечание: Использование разных AS для узлов (4200000021 - 4200000023) демонстрирует гибкость настройки multipath-relax. Система считает пути эквивалентными, даже если AS_PATH отличается по номеру (но совпадает по длине).
5 Перенос на физическую архитектуру Leaf-Spine
Программный стенд является точной логической копией промышленной сети Leaf-Spine (Clos Fabric). Вот как роли распределяются при переносе на "железо":
5.1 Spine (Магистральные коммутаторы)
frr1 и frr2 — это аналоги Spine-коммутаторов.
- В физической сети они не имеют прямого подключения друг к другу.
- Их единственная задача — максимально быстро перекладывать пакеты между Leaf-коммутаторами, используя ECMP.
5.2 Leaf (Коммутаторы доступа)
В текущей схеме роль Leaf выполняют сетевые интерфейсы самих серверов.
- В классической схеме серверы подключаются к Leaf-коммутаторам (например, через L2 или BGP Unnumbered).
- Leaf-коммутаторы, в свою очередь, анонсируют маршруты серверов вверх на Spine-уровень.
5.3 Роль Leaf-коммутатора (ToR)
Leaf больше не является Default Gateway для сервера в привычном понимании (через ARP/VLAN).
- Соседство: Каждый сервер поднимает eBGP-сессию напрямую с двумя разными Leaf-коммутаторами.
- Интерфейсы: Между сервером и Leaf настраивается либо /31 подсеть, либо используется BGP Unnumbered(маршрутизация через IPv6 Link-Local адреса, что экономит IPv4 пространство).
- Чистота конфигурации: На Leaf-коммутаторах отсутствуют VLAN-интерфейсы (SVI) для клиентского трафика. Есть только BGP-пиринг.
5.4 Преимущества сохранения L3 в ОС (Host-based Routing)
- Масштабируемость (Scale-out): Чтобы добавить в кластер еще 100 узлов, не нужно менять настройки VLAN на коммутаторах. Просто подключаются кабеля, и сервер сам анонсирует свои ресурсы в общую сеть.
- Устранение «L2-домена»: Проблемы одного сервера (например, ARP-шторм или петля) физически не могут повлиять на соседние сервера, так как они изолированы на уровне L3.
- Контроль трафика: ОС сервера сама решает, через какой интерфейс (Leaf 1 или Leaf 2) отправить пакет, основываясь на метриках BGP. Мы получаем честный ECMP прямо от процессора сервера до ядра сети.
- Мобильность сервисов: Можно перенести любой сервис или базу данных на другой физический сервер в любой части ЦОДа, и его Anycast IP (VIP) просто «переедет» вместе с ним, а BGP обновит маршруты по всей фабрике за доли секунды.
5.5 Техническая реализация на "железе"
5.5.1 BGP Unnumbered (RFC 5549)
Это ключевая технология, которую можно бы реализовать. В FRR она уже поддерживается.
- Суть: Вместо того чтобы прописывать neighbor 10.1.0.1, пишем neighbor enp2s0 interface.
- Зачем: Это избавляет от необходимости планировать и распределять тысячи мелких /31 подсетей для связи "сервер-коммутатор".
5.5.2 Dual-ToR и ECMP
В классическом L2 для подключения сервера к двум коммутаторам нужен сложный MLAG/vPC.
- В решении: Никаких MLAG. Сервер просто имеет две независимые BGP-сессии. Если один коммутатор (Leaf) уходит на обслуживание, BGP на сервере это видит (через BFD) и переключает весь трафик на второй линк.
6 Вывод
Приведенная в качестве примера текущая конфигурация стенда на FRR практически готова к развертыванию на реальное железо и рекомендуется для применения в составе ОТВ эв3.
- Железо: Подойдут любые коммутаторы с поддержкой BGP (Bare-metal коммутаторы с SONiC, Cumulus Linux или классические Arista/Cisco).
- Автоматизация: При описанном подходе конфигурация Leaf-коммутаторов становится однотипной («шаблонной»), что идеально для Ansible или Terraform.
- Гибкость: Пользователь получает сеть, которая работает как интернет — максимально надежно и на базе открытых стандартов.